Data, na kterých je založen vědecký výzkum, jsou to, co pohání pokroky ve vědeckém porozumění. Tyto datové soubory obsahují zásadní vodítka k mnoha nejnaléhavějším otázkám, kterým dnes vědci čelí, a mohou vrhnout nové světlo na minulá zjištění – buď potvrzovat, nebo zneplatnit existující vědecké záznamy a otevírat možnosti pro nový výzkum a nové porozumění. Tento druh informací však často mizí během procesu publikování vědeckých poznatků, buď proto, že data nejsou sdílena, nebo nejsou zpřístupněna ve formátu, který je snadno přístupný a dotazovaný.
„Ve vědě je spousta úžasných děl publikována jako PDF dokumenty. Možnost vytisknout a přečíst článek je pro lidi skvělá, ale mnoho informací, které byly použity při vytváření toho, co je hlášeno v PDF, skončí skryto. Pokud chceme získat celkový pohled a podívat se na všechny experimenty, které byly provedeny a byly popsány v literatuře týkající se určitého procesu nebo reakce, je pro nás velmi obtížné extrahovat všechny tyto informace ze všech těchto souborů PDF. “ vysvětluje Simon Hodson, výkonný ředitel společnosti ISC-CODATA.
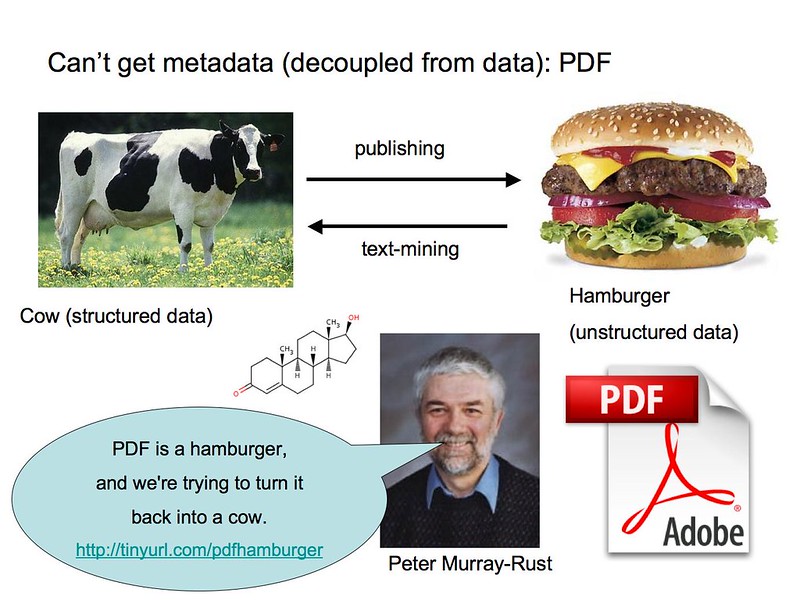
Slovy chemika Peter Murray-Ruste, získávání užitečných informací z PDF souborů může být jako „rekonstruovat krávu z hovězího burgeru“.
Existuje velké množství vědeckých dat, která byla vytvořena v průběhu mnoha let výzkumu, ale v mnoha případech to není možné - a rozhodně ne snadné - najít tato data a dotazovat se na ně, aby je bylo možné porovnat s jinými zjištěními nebo probíhajícími pracemi. Tváří v tvář tomuto rébusu a v souladu s imperativem otevřené vědy výzkumníci v současné době pracují na dalším umožnění vědy založené na datech prostřednictvím rámců, které podporují dostupnost a interoperabilitu dat.
Jedním z nejnovějších a nejprominentnějších přístupů k tomu je FAIR, který shrnuje, jaká data musí být, aby byla co nejpoužitelnější a nejhodnotnější: FAIR data jsou data, která jsou Fnezdravý; Apřístupný; Iinteroperabilní a Re-použitelný.
„Nalezitelné“ znamená, že vědecké údaje, které jsou zveřejněny jako součást podkladů pro vědecká zjištění nebo které jsou výsledkem veřejně financovaného výzkumu, by měly být k dispozici ostatním, aby je mohli najít a použít. Data by měla mít trvalý a jednoznačný identifikátor a také dostatečně bohatá metadata, aby bylo možné je objevit.
„Existují dobré důvody pro ochranu některých dat,“ říká Simon Hodson, „ale tam, kde tyto úvahy neplatí, principy FAIR znamenají, že byste měli mít přístup k datům přes web, možná s povolením, pokud existují bezpečnostní problémy. . Zásadní je, že principy FAIR tvrdí, že vědci by měli mít možnost přistupovat k výzkumným datům programově, tedy také pomocí svých strojů. Nejde jen o to, že můžete získat data a stáhnout je: v ideálním případě byste měli být schopni se na ně dotazovat pomocí počítačového kódu.“
I ve FAIR odkazuje na „interoperabilní“ – což znamená, že můžete kombinovat data z různých zdrojů: to do značné míry závisí na standardech pro metadata a dohodnuté terminologii nebo slovníku. Například metadata pro sociální průzkum z dané země by jasně vysvětlovala věkové kategorie nebo socioekonomické kategorie, které byly použity, a kde leží hranice kategorií, takže data by bylo možné snadno porovnat s daty ze sociálního průzkumu. v jiné zemi.
R znamená opětovnou použitelnost: zahrnuje to mít licenci, která lidem umožňuje opakovaně používat data a jasně uvádí podmínky pro jakékoli opětovné použití. Znamená to také mít informace o původu dat (například jak byly shromážděny, jaké úpravy nebo kalibrace byly použity, jakému dalšímu zpracování a čištění dat prošlo atd.), aby výzkumníci mohli pochopit potenciální silné stránky a omezení data a používat je s důvěrou.
FAIR data jsou také 'Fully AI Ready'. Aby bylo možné pomocí strojového učení identifikovat vzorce a začít předpovídat výsledky napříč různými datovými sadami, je nezbytné mít definice pro různé proměnné v datové sadě a definice musí být snadno dostupné.
„Když jsou data a související služby FÉR, pak je vše popsáno tak, aby počítač – a kdokoli, kdo používá kód – věděl, jaká definice byla pro koncept a související proměnnou použita, způsob, jakým byla získána měření, a hodnoty samotné. Pak můžeme interagovat s datovým kódem, možná jej rozložit, vzít podmnožinu a zkombinovat ji s jinými daty. Pokud jsou data FÉROVÁ, lze to dělat mnohem efektivněji a analýza a výzkum samotné jsou přínosné,“ říká Simon Hodson.
Myšlenka mít standardizované slovníky, pomocí kterých lze vyjádřit základní pojmy v různých oblastech vědy, není v žádném případě nová. The Mezinárodní unie čisté a aplikované chemie (IUPAC), člen ISC, reaguje na potřebu mezinárodní standardizace v chemii již od svého založení v roce 1919. Dnes je naprosto nezbytné, aby standardní slovníky byly přizpůsobeny digitálnímu věku a samy byly FÉROVÉ. Jako výsledek workshopu organizovaného s iniciativou Data Documentation zveřejnila skupina vedená Simonem Coxem (bývalým členem výkonného výboru CODATA a expertem na používání terminologie) „Deset jednoduchých pravidel pro to, aby slovní zásoba byla FAIR".
Podle těchto pokynů CODATA v současné době pracuje na FAIR slovníku pro jazyk Profily informací o nebezpečí zveřejněné ISC v říjnu 2021. Tím se vytvoří webová terminologie pro všechna popsaná nebezpečí, která bude zpřístupněna na GitHubu a prostřednictvím služby Research Vocabularies Australia, aby ji mohl používat kdokoli. To znamená, že vlády, které vyvíjejí své strategie a opatření v oblasti snižování rizik a řízení, budou moci rychle porovnávat data například s vlastními statistikami o ztrátách při katastrofách nebo s rámcem pro podávání zpráv.
CODATA také pracuje na slovnících FAIR s několika různými členy ISC, například s Mezinárodní unií pro vědecké studium populace (IUSSP). Demografie je obor bohatý na data a je vysoce relevantní pro pochopení udržitelného lidského rozvoje. Tím, že klíčové terminologie v populačních vědách bude FAIR, IUSSP přispěje k tomu, aby demografická data byla užitečnější pro statistické agentury a sociální vědce, stejně jako pro ty, kteří je používají v mnoha oblastech studia, které využívají údaje o populaci, včetně většiny oblastí souvisejících s udržitelným rozvojem. Rozvojové cíle (SDG).
CODATA bude také provádět podobnou práci s IUPAC v rámci nového dvouletého projektu „WorldFAIR: Globální spolupráce na FAIR datové politice a praxi“, financovaný Evropskou komisí prostřednictvím svého rámcového programu Horizon Europe. Koordinuje KODATAS Aliance pro výzkum dat sdružení jako hlavní partner bude projekt WorldFAIR pracovat se sadou jedenácti doménových a mezioborových případových studií s cílem pokročit v implementaci datových principů FAIR, zejména těch pro interoperabilitu, a vytvořit soubor doporučení a rámec pro FAIR hodnocení v souboru disciplín nebo mezioborových výzkumných oblastech. WorldFAIR bude tvořit jádro příspěvku CODATA k projektu ISC Aby data fungovala pro velké výzvy napříč doménami.
IUPAC vede případovou studii chemie, která se zabývá tím, jak učinit informační aktiva a terminologie, které IUPAC spravuje, vhodné pro dobu digitalizace a FAIR dat. IUPAC se také zapojí do dalších případových studií WorldFAIR o nanomateriálech a geochemii.
Dalším partnerem WorldFAIR je Drexel University, USA, která vedla projekt Salud Urbana en América Latina („Urban Health in Latin America“) (SALURBAL). SALURBAL vyvinul a datový soubor pro více zemí o oblastech, jako jsou demografické charakteristiky, úmrtnost, zdravotní chování a rizika, sociální prostředí a zastavěné prostředí, což umožňuje srovnání měst a čtvrtí v rámci měst v celé Latinské Americe. Tento úžasný zdroj umožní politicky relevantní výzkum o příčinách zdraví a zdravotních nerovností ve městech regionu. SALURBAL již vykonal rozsáhlou práci na harmonizaci dat. WorldFAIR pomůže vnést více světla do této práce a poskytne doporučení pro FAIR terminologii v městském zdraví.
Série podcastů CAG-CEPT, CODATA a UHWB na téma „Data-Knowledge-Action for Urban Systems“
Série podcastů Data-Knowledge-Action for Urban Systems zkoumá systémy používané k budování inteligentních městských systémů. Série reflektuje systematické změny potřebné k tomu, aby se města stala adaptivní a inteligentní pro zvládnutí městské pohody. Je hostitelem Centra pro aplikovanou geomatiku, CODATA a Urban Health and Wellbeing Program (UHWB).
Ve dnech 15. a 16. února Simon Hodson informoval o práci CODATA v rámci setkání pro sdílení znalostí pro členy ISC na téma Sbližování vědy a techniky v digitální éře.

Můžete se dozvědět více o projektu WorldFAIR, o práci CODATA na slovnících FAIR a o iniciativách v různých výzkumných disciplínách, aby byla data a informační aktiva FAIR na adrese Mezinárodní datový týden 2022, 20.-23. června.
Obrázek od École polytechnique – J.Barande přes Flickr.
 Přečtěte si více o tom, jak budujeme globální znalostní infrastrukturu pro svět, který máme, nebo pro svět, který se snažíme vytvořit?
 Přečtěte si více o budování vědeckých systémů připravených na budoucnost v zemích globálního Jihu
 Přečtěte si více o Výzva je nyní uzavřena pro odborníky pro pracovní skupinu IPCC pro datovou podporu pro hodnocení změny klimatu
